Колко RAM ти трябва, за да пускаш AI локално на лаптоп?
Изтегляне от 3,4 GB с име qwen3.5:4b-q4_K_M (LLM, голям езиков модел) може още тази вечер да ти отговори на въпрос на съвсем обикновен лаптоп с 16 GB, без да ти трябва облачен акаунт. Изтегляш го с Ollama, задаваш въпрос с 4K контекст и вече пускаш истински AI модел локално, на хардуера, който вече имаш. Той чете текст и изображения, а тук говорим за inference, не за обучение: никой не учи модела на нищо ново, той просто отговаря.
Неясният стикер „AI PC“ върху кутията на лаптопа не е спецификация. Спецификации са RAM паметта, паметта, която GPU може да използва, сториджът и реалната софтуерна поддръжка. 16 GB памет са истинска отправна точка за малки AI модели, не нещо, което веднага да отпишеш като недостатъчно, но и не обещание за всичко, което пише в спецификациите. Повече памет ти дава повече контекст и повече свобода за многозадачност. С 16 GB можеш да започнеш.
Какво всъщност използва RAM паметта на лаптопа, когато пускаш AI
Размерът на файла, който изтегляш, и RAM паметта, която моделът заема, докато работи, са две различни числа. Точно объркването между тях е най-честата грешка при избора на лаптоп за AI. Онези 3,4 GB, които сваляш за qwen3.5:4b-q4_K_M, са файлът на диска. За да го заредиш обаче, ти трябва реална памет. Същото важи и за контекстния прозорец, тоест активния разговор, който моделът държи в контекст, докато отговаря, наричан KV cache. Памет използват и самият engine, и всичко друго, което операционната система и останалите приложения вече заемат.
Ollama по подразбиране зарежда контекст от 4096 токена и можеш да го увеличиш. Ако пускаш няколко заявки едновременно, нужната памет за контекст нараства приблизително според броя паралелни заявки. В спецификациите на даден модел може да пише контекстен прозорец от 128K или 256K токена, приемай това като максимума на модела, не като обещание, че лаптопът ти с 16 GB може да използва всичко наведнъж.
RAM, VRAM и unified memory не са една и съща памет
Чиповете Apple Silicon използват unified memory: CPU и GPU ползват един и същ общ обем от 16, 24 или 32 GB, така че няма отделна графична памет, която да свърши първа. При типичен лаптоп с Windows или Linux и отделна NVIDIA видеокарта нещата стоят различно. Системната RAM и собствената VRAM на GPU са два отделни ресурса, а 16 GB системна RAM плюс GPU с 8 GB не са общ басейн от 24 GB, който моделът може свободно да използва.
Когато моделът не се побира изцяло в GPU, част от него се изпълнява на CPU. Това частично прехвърляне може да направи и иначе зареждащ се модел осезаемо по-бавен. Ако пуснеш , ще видиш точно това разделение между CPU и GPU за всичко, което е заредено в момента.
Капацитетът е само част от картината. Също толкова важно е колко бързо се движат данните в тази памет: Apple посочва 153 GB/s пропускателна способност на паметта при MacBook Air M5 и именно тя, а не само размерът, е важна причина unified memory да реагира пъргаво, а не просто да е достатъчна на хартия.
Квантизация: как AI модел с 9B се побира в твоята RAM
Квантизацията стои зад онзи файл от 3,4 GB: когато теглата на модела се съхраняват с по-ниска числова точност, файлът става по-малък, а диапазонът при собствения 9B модел на Qwen3.5 го показва много ясно. Един и същ 9B модел се сваля като 6,6 GB във вариант Q4_K_M, 11 GB като Q8_0 и 19 GB при пълна BF16 точност. Един и същ модел, един и същ брой параметри, три много различни размера за изтегляне, и отново говорим за размера на файла, а не за RAM паметта, нужна по време на работа.
По-ниската точност обикновено струва част от качеството, но колко точно, зависи от задачата, не от някакъв фиксиран процент. Има и една практическа особеност, която е добре да знаеш, преди да избереш Qwen за първи модел: някои потребители съобщават, че стъпката му за „мислене“ добавя осезаемо забавяне преди появата на отговора в сравнение с модели, които отговарят по-директно. Затова си струва да пробваш и двата подхода със собствените си задачи, вместо да приемаш, че единият просто е по-добър.
Имаш MacBook с 16 GB? Пробвай това, преди да купиш каквото и да е
Ако вече имаш MacBook с 16 GB, започни с модел 2-4B при Q4 точност и 4K контекст, преди изобщо да мислиш за покупка на нещо друго. Възможно е да се зареди и 9B Q4 модел или нещо като Gemma 4 12B QAT. Дали това ще стане зависи от това колко други приложения са отворени, колко голям контекст използваш и колко натоварена е машината в момента, така че го приемай като нещо, което си струва да тестваш, а не като гаранция.
Ако купуваш нов лаптоп точно за това, MacBook Air 13-inch with M5 chip идва стандартно с 16 GB unified memory и може да се конфигурира до 32 GB. И преди по-големият дисплей да ти се стори логичен ъпгрейд: 15-инчовият M5 Air започва със същите опции за памет от 16, 24 и 32 GB и със същата пропускателна способност от 153 GB/s като 13-инчовия модел. Избери размера на екрана за удобство, а не с мисълта, че така ще получиш повече резерв за AI. Няма да получиш.

Имаш лаптоп с Windows или Linux и 16 GB? Започни оттук
Лаптоп с Windows или Linux, 16 GB RAM и без отделна видеокарта все пак може да пусне малък модел. Ollama работи нативно под Windows, така че изтегли 2-4B Q4 модел и го пробвай на CPU или вградената графика, преди да харчиш каквото и да е. Очаквай повече разлики в усещането, отколкото при Apple Silicon: няма едно фиксирано число за tokens per second, което да важи за всяка машина, защото никой не е измерил всяка възможна конфигурация.
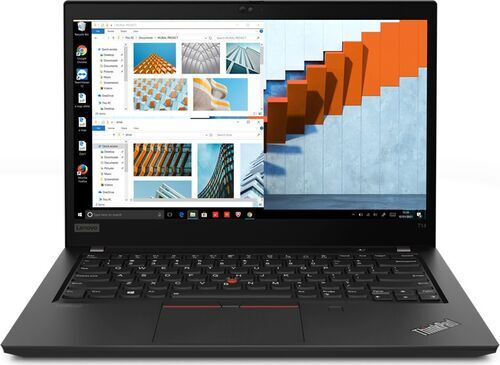
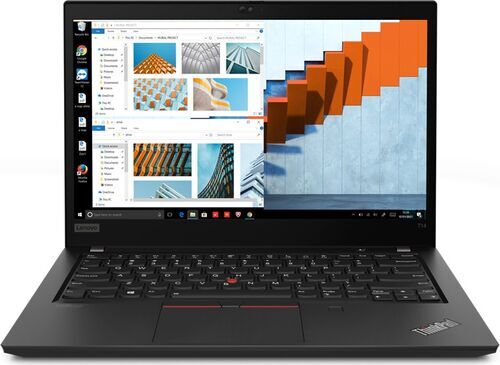
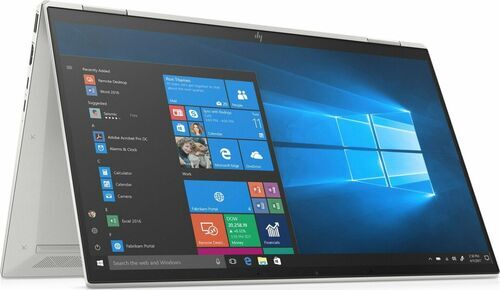
Lenovo ThinkPad T14 G2 и HP EliteBook x360 1040 G7 са точно в този клас: и двата идват с 16 GB RAM и вградена графика. Има обаче едно нещо, което си струва да провериш първо, особено при по-стар реновиран лаптоп като някой от тези два: LM Studio изисква AVX2 поддръжка за Windows x64, а не всеки по-стар процесор я има. Провери дали конкретният процесор я поддържа, преди да приемеш, че всеки лаптоп в този диапазон ще работи с избрания от теб инструмент.
Капанът в имената на GPU за лаптопи: защо „RTX 5070 Ti“ не е едно-единствено число
GPU моделите за лаптопи на NVIDIA споделят имена с настолните карти и това име казва по-малко, отколкото изглежда. RTX 5060 Laptop GPU идва с 8 GB GDDR7 памет и обявен диапазон на мощността от 45 до 100 W. RTX 5070 Ti Laptop GPU е с 12 GB GDDR7 и 60 до 115 W. Резултат онлайн за настолна RTX 5070 Ti не е резултат за лаптопска RTX 5070 Ti, каквото и да подсказва името.
В същото име има и втори капан. Два лаптопа могат и двата да са с „RTX 5070 Ti Laptop GPU“ и въпреки това да се държат различно при продължително натоварване: тънкият и лек корпус и по-дебелият и тежък корпус отвеждат топлината по различен начин, а еднаквото име на GPU не гарантира една и съща реална скорост, след като вентилаторите поработят известно време. Винаги проверявай точния обем VRAM и конкретната конфигурация на мощността на лаптопа, а не само името на GPU серията.
Купуваш Mac за това? Ето удобното ниво при unified memory
Ако купуваш лаптоп специално за редовно локално пускане на AI, 24 до 32 GB unified memory е по-удобното ниво при Apple: така остава място за по-голям модел, по-дълъг контекст или просто за други отворени приложения, докато работиш. Насочи се към 32 GB, ако очакваш да използваш това често и бюджетът ти го позволява.
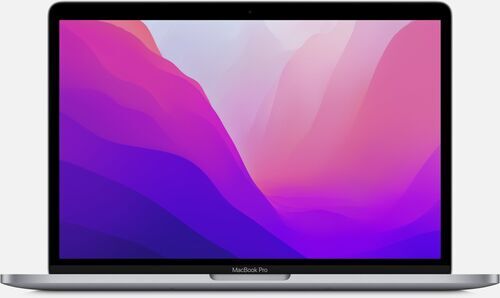
MacBook Pro 13-inch with M2 chip е конкретен реновиран пример, който вече стои над входното ниво от 16 GB: неговите 8-ядрен CPU и 10-ядрен GPU вървят с до 24 GB unified memory. Това е по-старо поколение чип спрямо M5 Air, така че тук трябва да очакваш собствената му горна граница от 24 GB, а не отделните опции 24/32 GB при M5 Air.
Купуваш Windows или Linux лаптоп? Търси отделна видеокарта
Ако търсиш нов лаптоп с Windows или Linux именно за локален AI, ориентирай се към 32 GB системна RAM плюс отделна NVIDIA видеокарта за лаптоп с поне 8 GB собствена VRAM, а 12 GB са още по-добър вариант, ако приемаш малко по-тежък или по-скъп лаптоп. 8 GB са реалистична цел за модели 4-7B при Q4 точност и умерен контекст, но не приемай това за автоматичен запас: дори файлът от 6,6 GB за 9B Q4 модел може да иска повече от чисти 8 GB, за да работи спокойно, а 12 GB просто правят тестването в този размер по-лесно.
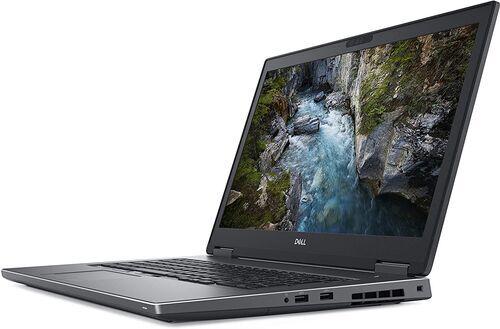
Dell Precision 7730 е конкретен реновиран пример за основната идея, макар и не с точно същите нови чипове като горните: 32 GB системна памет вървят заедно с отделна NVIDIA Quadro P3200 със собствени 6 GB VRAM, различно поколение и клас GPU спрямо актуалните RTX 5060 и 5070 Ti Laptop GPU на NVIDIA, но със същия принцип на отделните ресурси памет.

Една разумна алтернатива: лаптоп чипове на AMD с много памет
Процесорът Ryzen AI Max+ 395 на AMD поддържа до 128 GB LPDDR5x системна памет, според това как е конфигуриран конкретният лаптоп. Това е различна архитектура на паметта, която си струва да познаваш, но има и една съвсем практична уловка: в списъка на Ollama за Linux с ROCm този чип присъства, докато в списъка за Windows с ROCm засега не присъства.
Това не е причина веднага да отхвърлиш чипа, а причина да провериш точната инсталирана памет, операционната система, GPU backend-а, драйвера и поведението на Ollama на конкретния лаптоп, преди да го препоръчаш. Гледай на лаптоп с AMD и много памет като на интересна алтернативна архитектура, която иска внимателно проучване, а не като на стандартната първа покупка за човек, който тепърва започва с локален AI.
Софтуерният слой: Ollama и LM Studio с прости думи
Ollama е най-лесният начин да накараш модела да работи на собствената ти машина: изтегляш модел, пускаш го и вече имаш локален сървър, който отговаря на заявки, без да ти трябва облачен акаунт за изтегления модел. Това е инструментът зад всички примери тук.
LM Studio предлага графична алтернатива със собствен браузър за модели и прозорец за чат. Той публикува и собствените си минимални изисквания: поне 16 GB RAM на Mac или Windows, задължителна AVX2 поддръжка при Windows x64 и препоръчителни 4 GB отделна VRAM под Windows. Правилната настройка и на двата инструмента е отделна тема.
И една уговорка, преди да се довериш на което и да е единично число за скорост, което видиш онлайн: официалният инструмент llama-bench отделя скоростта на обработка на prompt-а от скоростта на генериране и отчита вариации в повтарящи се тестове, вместо да дава само една стойност. Публикация във форум с едно число за tokens per second рядко казва кое от двете е измерено или колко пъти е правен тестът.
Провери това, преди да купиш или ъпгрейднеш лаптоп за AI
Преди да купиш или да правиш ъпгрейд специално за локален AI, гледай конкретиката, а не маркетинга.
Точният модел GPU и обемът VRAM. Не само името на серията, а точният вариант за лаптоп и конкретният му обем памет, защото зад едно и също име може да се крие различно количество VRAM.
Запоена или надграждаема RAM. При някои лаптопи можеш да добавиш памет по-късно, при много съвременни тънки и леки модели не можеш. Добре е да знаеш кое от двете купуваш.
Свободно SSD пространство. Изтеглянията на модели варират от под 1 GB до доста над 10 GB, а растящата колекция бързо се натрупва покрай останалите ти файлове.
Термично поведение при продължително натоварване. Има разлика между модел, който отговаря на един въпрос, и лаптоп, който обработва няколко поредни заявки. Шумът от вентилаторите и throttling-ът след поредица от prompt-ове ти казват повече от една кратка демонстрация.
Поддръжка на операционна система и драйвери. Потвърди, че точно твоята комбинация от GPU backend и операционна система се поддържа от Ollama или LM Studio, преди да разчиташ на нея.
Числото NPU TOPS върху кутията не е гаранция за реална производителност. Това е маркетингов показател, а не тестван резултат от engine-а, който ще използваш. Неясният етикет „AI PC“ не замества нито една от горните проверки.
Пет реновирани лаптопа, които вече покриват тези нива

Често задавани въпроси за пускането на AI на лаптоп
Трябва ли ми отделна видеокарта, за да пускам AI локално?
Не. Малък модел може да работи на CPU или вградена графика при много лаптопи с 16 GB, просто с осезаемо повече разлики в скоростта спрямо лаптоп с отделна видеокарта. Започни с модел 2-4B, преди да приемеш, че изобщо ти трябва отделна графика.
Ще свършат ли работа 8 GB RAM?
Не особено удобно за моделите, за които става дума тук. 16 GB е реалистичната начална точка, след като отчетеш, че моделът, контекстният му прозорец, engine-ът и операционната система споделят една и съща памет.
Същото ли е да пускаш модел локално и да го обучаваш?
Не. Всичко по-горе е inference: задаваш въпроси на вече обучен модел. Обучението създава модел от нулата и иска много повече хардуер от всеки лаптоп тук.
Повече RAM гарантира ли по-бързи отговори?
Не. Повече памет дава повече място за по-големи модели, по-дълъг контекст и повече отворени приложения, но реалната скорост зависи от пропускателната способност на паметта, GPU backend-а и конкретния модел, не само от размера на паметта.
Личните ми данни остават ли поверителни, когато моделът работи локално?
Да, в смисъл че prompt-овете ти остават на твоята машина, вместо да отиват към облачен доставчик. По подразбиране Ollama е вързан към собствения ти лаптоп и не изпраща заявки никъде другаде, освен ако умишлено не настроиш облачен достъп.
Пробвай още тази вечер, после избирай спокойно
Имаш ли вече лаптоп с 16 GB? Инсталирай Ollama още тази вечер и пусни един малък модел, преди да дадеш и стотинка за нещо ново. Купуваш специално за това? Използвай списъка по-горе и петте реновирани лаптопа, които току-що разгледахме, като начална база за сравнение, вместо да разчиташ на маркетингов лист със спецификации.
Всеки лаптоп в refurbed е тестван и оценен по състояние, преди да бъде обявен, така че RAM паметта и конфигурацията, които купуваш, са точно тези, които получаваш. Следващото ръководство от тази поредица показва как да свържеш първото си приложение с модела, който току-що изпробва.


Абонирайте се за нашия бюлетин за първи път и спестете 15 €!
Никога повече не пропускайте оферта.
Информация за използването на лични данни може да бъде намерена в нашата Политика за поверителност.
Изтеглете приложението refurbed
За iOS и Android


Потвърдете регистрацията
Почти готово: Изпратихме ви имейл за потвърждение
- © Refurbed Marketplace GmbH
- Достъпност
- Общи условия
- Политика за поверителност
- Импринт
- Правни уведомления
- European Data Act
- Cookie Policy